2分でインストール完了
IMGLAB Image URL ExporterはChrome拡張機能です。一度インストールするだけで、x.comとtwitter.comのすべてのページにパネルが自動表示されます。
製品ページの「Chromeに追加 — 無料」をクリックします。確認ダイアログが表示されたら「拡張機能を追加」をクリック。IMGLABアイコン 🧪 がChromeツールバーに表示されます。登録・アカウント・支払いは一切不要です。
任意のTwitterプロフィールを開き、メディアタブ(写真・動画グリッド)を表示します。または検索バーで次のようなクエリを実行してください:
IMGLABパネルがページの右下に自動表示されます。表示されない場合は、ツールバーの 🧪 アイコンをクリックして「ページ上のパネルを切り替え」を押してください。
IMGLABパネルの▶ スタートをクリックします。拡張機能がツイートのスキャン、Twitter APIの呼び出し、画像URLの収集を開始します。自動スクロールがコンテンツを読み込む間、リアルタイムで統計が更新されます。
収集完了後、urls.txtがダウンロードフォルダに自動保存されます。IMGLAB Image Downloader(別アプリ・ベータ版・寄付が必要)に読み込むと、すべての画像を整理されたサブフォルダへバッチダウンロードできます。URLリストに対応した他のバッチダウンロードツールも使用可能です。
パネルの各機能
IMGLABパネルはx.comに直接挿入されます。ドラッグ移動・最小化が可能で、操作の邪魔をしません。各要素の機能を説明します。
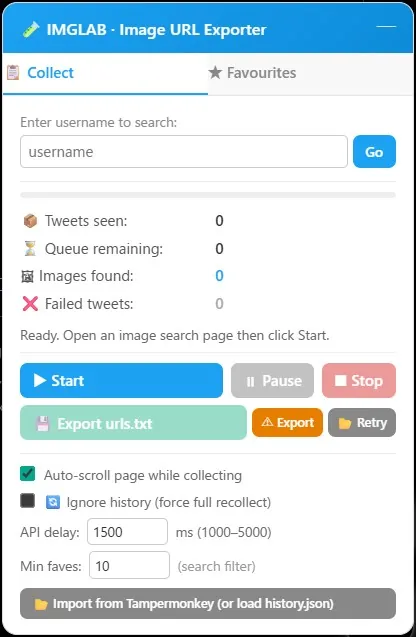
URLから検出した現在のユーザーまたはハッシュタグを表示します。プロフィールページでは👤 @ユーザー名、検索ページでは🔍 検索を更新が表示されます。★スターボタンで現在のユーザーまたはハッシュタグをお気に入りに追加。検索を更新ボタンで現在のmin-favesフィルターを適用した検索URLを再生成します。
このユーザーまたはハッシュタグから過去に収集したことがある場合、緑色のバッジで前回のダウンロード日と総画像数を表示します。ローカルアーカイブがどれだけ最新かを一目で確認できます。
検索のトップタブ(関連度順・時系列順ではない)を表示中の場合、アンバーの警告バナーが表示されます。このモードでは:履歴境界チェックがスキップされ、セッション後に履歴は保存されず、「過去に遡る」ボタンも非表示になります。関連度順には信頼できる日付の順序がないためです。
f=live)に切り替えてください。収集中、4つのカウンターがリアルタイムで更新されます:
📦 確認ツイート数 — DOMで検出した総ツイートID数
⏳ キュー残数 — API処理待ちのツイート数
🖼 取得画像数 — 正常に抽出された写真URL数(青色)
❌ 失敗ツイート数 — 全リトライ後もエラーになったツイート(0より大きい場合は赤)
下部のプログレスバーはキュー処理に応じて増加します:% = 処理済み / 確認総数
▶ スタート — 新しい収集セッションを開始します。セッション完了後は無効化されます(再開するには新しいページに移動するか「過去に遡る」を使用)。
⏸ 一時停止 / ▶ 再開 — API処理と自動スクロールを一時停止します。キューは保持されます。再クリックで中断した箇所から正確に再開します。
⏹ 停止 — 収集を即座に停止します。バックフィルモードまたはトップタブモード以外の場合、現時点での履歴保存を確認するプロンプトが表示されます。
💾 Export urls.txt — 収集した画像リストをタブ区切りテキストファイルとしてダウンロードします。セッション終了時にも自動実行されます。
⚠ エクスポート — 処理できなかったツイートのURLをfailed.txtとしてエクスポートし、手動で再試行できます。
📂 リトライ — 以前エクスポートしたfailed.txtをIMGLABに再読み込みして、特定のツイートを再処理します。
自動スクロール — 収集中にページを自動スクロールして新しいツイートを読み込みます。デフォルトで有効。
履歴を無視する — 履歴が存在する場合でも強制的に完全再収集します。アーカイブを完全に更新したい場合に使用。
APIディレイ — API呼び出し間隔(1000〜5000ms)。値を下げると収集が速くなりますが、レート制限のリスクが増加します。デフォルトの1500msが安全なバランス。
最小いいね数 — 検索クエリにmin_faves:Nを追加します。エンゲージメントの低いツイートを除外。「検索を更新」ボタンで現在のURLに適用できます。
収集モードと動作
IMGLABは自動的にコンテキストを検出し、動作を調整します。4つの収集モードを理解することで、各セッションを最大限に活用できます。
現在のコンテキストに保存済みのツイートIDが存在する場合、保存済み境界以下のIDに到達するまで通常通り収集し、そこで自動スクロールを停止してキューの処理を完了します。前回のダウンロード以降の新着ツイートのみを収集。繰り返しの訪問で大幅な時間節約になります。
until:が含まれる場合セッション終了後に「過去に遡る」をクリックすると、IMGLABがuntil:日付付きの新しい検索URLを生成します。このページでIMGLABはバックフィルモードを検出し、履歴境界チェックを無効化。最新IDのレコードを上書きせずに古いアーカイブを安全に収集できます。バックフィルセッション終了時、履歴は更新されません。
fパラメータなし、またはf=topの場合Twitterの「トップ」タブは日付順ではなく関連度順に並べられます。IMGLABはアンバーの警告を表示し、履歴境界をスキップし、「過去に遡る」を非表示にし、セッション後に履歴を保存しません。関連度順セッションの最新ツイートIDは意味がなく、インクリメンタル収集を破壊するためです。正しいインクリメンタル収集には「最新」タブに切り替えてください。
3回のAPIリトライ後も失敗したツイートはfailedIds[]に記録されます。⚠ エクスポートでファイルを書き出し、📂 リトライで再読み込みします。IMGLABはそれらの特定のツイートIDのみを再キューイングし、新しいAPI呼び出しで再処理します。以前に収集した画像は保持され、リトライ結果が追加されます。
スタート時、IMGLABはすべての表示中の<article>要素を即座にスキャンします。各記事の最初のa[href*="/status/"]リンクからツイートステータスIDを抽出し、メディアが含まれているか(写真リンク、data-testid="tweetPhoto"、センシティブコンテンツ表示)を確認して、条件を満たすIDをペンディングキューに追加します。MutationObserverでスクロールによって読み込まれた新しい記事を監視します。
キュー内の各ツイートIDは、ご自身のブラウザセッションCookieで認証しながらTwitterのTweetResultByRestId GraphQLエンドポイントに送信されます。レスポンスにはフルのツイートオブジェクトが含まれており、IMGLABはすべてのtype: "photo"メディアを抽出し、?format=jpg&name=orig付きのオリジナル解像度URLを構築し、構造化されたファイル名を生成します。リツイートと引用ツイートは個別に処理され、写真が正しい作者に帰属します。
APIがHTTP 429を返した場合、IMGLABはx-rate-limit-resetヘッダーを読んで正確な再開時刻を特定し、パネルにカウントダウンタイマーを表示して、ウィンドウが開いたら自動的に再開します。現在のツイートはキューの先頭に戻され、最初に再試行されます。レート制限の一時停止中にデータは失われません。
キューが空になり自動スクロールで新しいツイートが見つからなくなると、finishCollection()が実行されます。データ消失防止のためurls.txtが最初に自動ダウンロードされます(早期リターンの前)。次に、収集したファイル名から最新のツイートIDが抽出されchrome.storage.localに保存されます。失敗があった場合、部分的なセッションが境界を破壊しないよう履歴保存の確認プロンプトが表示されます。
履歴トラッキング
IMGLABはユーザーとハッシュタグごとに最新のツイートIDを記憶します。これにより、前回のセッション以降に公開されたコンテンツのみを収集するインクリメンタル収集が可能になります。
@usernameまたは#hashtagをキーとするオブジェクト。各エントリ:newest_tweet_id、last_downloaded(日付文字列)、total_images数。
{ type, name, displayName }オブジェクトの配列。typeは"user"または"hashtag"。nameは@usernameまたは#tag-a #tag-bのようなフルストレージキー。
GET /imglab/historyでその履歴を取得し、ローカルストレージとマージします。常に最も高いツイートIDが保持されます。ダウンローダーセッションと拡張機能セッションは自動的に同期を維持します。複数ハッシュタグ検索
複数のハッシュタグを組み合わせた検索に完全対応しています。タグは五十音順にソートされるため、入力した順序に関わらずストレージキーは常に一定です。
#付き、五十音順ソート済み。imglab_historyキーとダウンローダーのフォルダ名として使用 — 両者は完全に一致します。twitter_urls_hashtag_tag-a_tag-b.txt — アンダースコア連結・#なし。ダウンローダーが自動的にフォルダ名に変換します。Tampermonkeyからのインポート
以前にTampermonkey版のIMGLABを使用していた場合、履歴をChrome拡張機能に移行できます:
パネルの設定セクションで📂 Tampermonkeyからインポート(またはhistory.jsonを読み込む)をクリックします。
エクスポートしたJSONファイルを選択します。IMGLABは自動的にフォーマットを検出します:フルエクスポート(imglab_history、imglab_favouritesなどのキーを含む)または履歴のみ(トップレベルキーが@usernameエントリ)。両フォーマットとも正確に処理されます。
ステータスバーがインポートされた履歴エントリ数、お気に入り数、ダウンロード済みID数を確認します。次の収集セッションはインクリメンタル境界から正確に開始されます。
urls.txtファイル
すべての収集セッションでタブ区切りのテキストファイルが生成されます。各行が1枚の画像を表し、URLとファイル名がタブ文字で区切られています。
?format=jpg&name=origサフィックスで最高品質を強制します。エクスポートファイル名の形式
twitter_urls_username_example_user.txt
twitter_urls_hashtag_tagname.txt
twitter_urls_hashtag_tag-a_tag-b.txt(五十音順ソート・アンダースコア連結)
twitter_urls_1735000000000.txt(Unixタイムスタンプによるフォールバック)
\ / | < > : * ? ")のみ全角の代替文字に置き換えられます。IMGLAB Image Downloader
ローカルマシン上で動作するPython + Gradio GUIアプリです。エクスポートしたurls.txtファイルを読み込むだけで、並列ダウンロード・重複スキップ・サブフォルダ整理・拡張機能への履歴同期まですべて自動処理します。
複数のurls.txtファイルを一度に読み込めます。同じユーザーのファイルは1つのバッチにまとめられます。異なるユーザーは順番に処理されます。正常完了後は次のユーザーが自動的に開始します。途中でStopを押すと残りのエントリがクリアされます。
1〜5の同時ダウンロード数をセッションごとに設定できます。デフォルトは3 — 速度とサーバー安定性の安全なバランス。高速接続での大量バッチには5に増やし、エラーが発生する場合は1に下げてください。
ユーザーファイルの場合、最初の画像のファイル名からサブフォルダ名を抽出し、表示名(@example_user)形式のフォルダ名になります。ハッシュタグ検索は#tag-a #tag-b形式を使用し、拡張機能のストレージキーと完全一致します。
ダウンロード前に、ダウンローダーが保存先パスにファイルが既に存在するかを確認します。既存ファイルは静かにスキップ — 再ダウンロードも上書きもしません。同じurls.txtを複数回読み込んでも安全です。
GET http://127.0.0.1:7861/imglab/historyを公開します。Chrome拡張機能のbackground.jsが起動時にこれを取得し、ローカル履歴とマージして常に最も高いツイートIDを保持します。手動同期は不要です。
Twitter Media Downloaderで既に何千枚もの画像をお持ちですか?「TMD履歴インポート」タブが既存のフォルダ構造をスキャンしてIMGLABの履歴ファイルを自動構築 — インクリメンタル収集が正確なポイントから開始されます。
()を除去します。重複ダウンロードでtwitter_urls_username_example_user (1).txtという名前になった場合、Gradioはtwitter_urls_username_example_user 1.txtとして処理します。ダウンローダーはこれを自動的に処理 — フォルダ名の抽出前に末尾の数字を除去します。既知の制限事項
TwitterのGraphQLエンドポイントはアカウントごとにレート制限を適用します。大量収集(1000ツイート以上)では通常1〜2回の自動一時停止が発生します。IMGLABはx-rate-limit-resetヘッダーを読み取り、カウントダウンタイマーを表示して自動的に再開します — ユーザー操作は不要です。一時停止中にデータは失われません。
IMGLABはツイートオブジェクトからtype: "photo"のメディアのみを抽出します。動画、アニメーションGIF、その他のメディアタイプは意図的にスキップされます。高品質なオリジナル解像度の静止画像に特化しています。動画のダウンロードは異なる技術的アプローチが必要であり、現在のスコープ外です。
拡張機能はご自身のブラウザセッションCookieを使用してAPI呼び出しを行います。ログイン中に閲覧権限があるツイートのみ収集できます。フォローしていない非公開アカウント、確認していない年齢制限コンテンツ、削除済みツイートにはアクセスできません — APIが単純に返さないためです。
TwitterはプライベートなGraphQLエンドポイントのIDと必要なフィーチャーフラグを定期的に変更します。これが発生するとAPI呼び出しが空の結果や予期しないエラーで失敗し、収集が機能しなくなります。エンドポイントを修正するためにIMGLABのアップデートが必要です。これがあらゆるTwitterスクレイピングツールの主要なメンテナンス負荷です。
収集セッションが完了すると(state === 'done')、そのページのスタートボタンは恒久的に無効化されます。これは意図的な設計です — 自動スクロールはページ先頭ではなく現在のスクロール位置から開始するため、同じページの再スキャンは信頼性がありません。
複数タグのファイル名形式はアンダースコアでタグ名を区切ります(例:hashtag_tag-a_tag-b.txt)。ハッシュタグ自体にアンダースコアが含まれている場合、ダウンローダーがファイル名をフォルダ名に変換する際に誤って2つのタグに分割します。
サポートと寄付
IMGLABを
継続させるために
拡張機能は無料です。広告なし、データ収集なし、サブスクリプションなし。すべてのアップデート — 壊れたAPIエンドポイントの修正、機能追加、エッジケースのテスト — には実際の調査と時間が必要です。あなたのサポートがそのすべてを支えています。
このプロジェクトの成長は正直なところコミュニティの支援にかかっています。満足のいく画像を保存できたなら — 一杯のコーヒーが「続けてください」という最良のメッセージです。
chrome://extensions/でIMGLABを見つけ、↺更新アイコンをクリックしてからx.comをリロードしてください。history.jsonバックアップを読み込むか、ブラウザDevToolsのService Workerコンソールで次のコマンドでエントリを確認・削除してください:chrome.storage.local.get('imglab_history', d => console.log(d))